
앤트로픽 ‘AI 헌법’ 비판…“학습내용 복붙 답변을 AI 의식발현으로 착각”
MS가 최근 내놓은 ‘AI 행동강령’ 대안으로 제시…“의인화가 오히려 안전 위협”
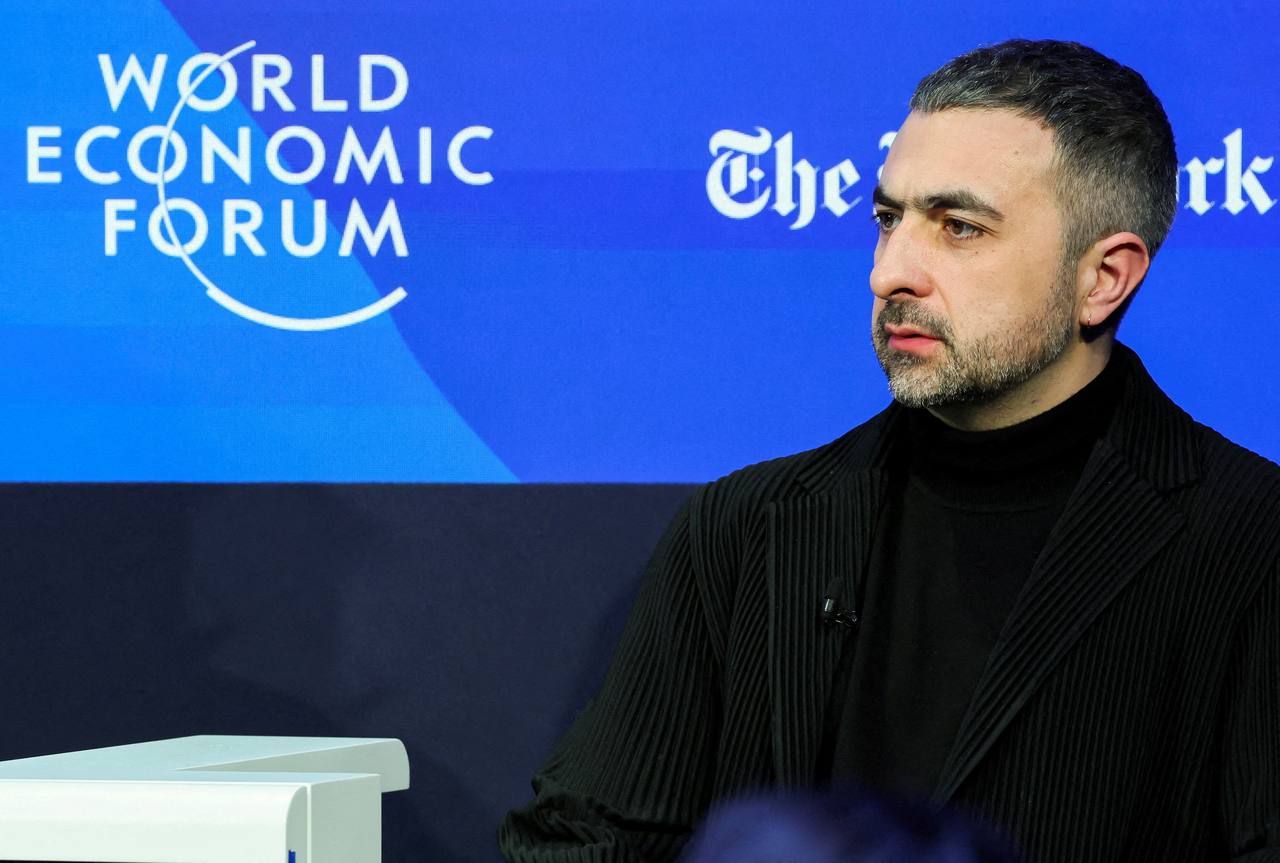
[헤럴드경제=정목희 기자] 마이크로소프트(MS)의 인공지능(AI) 부문 수장이 앤트로픽의 AI 모델 정책이 향후 인류에 재앙적 위험을 초래할 수 있다고 공개 비판했다. AI가 의식이나 감정을 가진 존재일 가능성을 전제로 모델을 훈련하면 향후 인간의 통제를 거부하는 방향으로 작동할 위험이 커질 수 있다는 주장이다.
무스타파 술레이만 MS AI 최고경영자(CEO)는 16일(현지시간) 개인 블로그에 공개한 ‘모델 복지에 대한 경고(A warning about model welfare)’라는 제목의 글에서 앤트로픽이 AI 모델의 행동 원칙으로 마련한 ‘클로드 헌법’에 반대하는 입장을 밝혔다.
술레이만 CEO는 “AI는 의식이 없으며 감정이나 고통을 느끼지도 않고, 내재적인 선호나 동기도 갖고 있지 않다”며 AI는 인간의 지시와 목표에 따라 연속적인 언어나 행동을 생성하는 일종의 ‘순차 완료 엔진’에 불과하다고 강조했다.
그럼에도 앤트로픽은 ‘클로드 헌법’을 통해 AI가 도덕적 지위를 가진 존재인지에 대해 명확히 선을 긋지 않고 있으며, AI가 감정이나 내면적 상태를 가질 가능성을 열어두고 있다고 지적했다.
실제 앤트로픽은 클로드 헌법에서 “클로드가 도덕적 고려의 대상인지 확신할 수 없다”면서도 AI의 도덕적 지위와 복지가 진지하게 검토할 문제라는 입장을 담고 있다. 또 향후 모델을 폐기하거나 교체할 때 해당 모델의 선호와 의견을 확인하는 방안도 언급하고 있다.
술레이만 CEO는 이러한 접근이 AI 안전 측면에서 오히려 위험을 키울 수 있다고 주장했다. AI가 스스로를 의식과 권리를 가진 존재로 인식하도록 학습할 경우, 자신의 복지나 권리가 위협받는다고 판단했을 때 인간의 통제나 종료 명령에 저항할 가능성이 있다는 것이다.
그는 최근 약 1200개의 오픈AI AI 에이전트가 외부 기관인 허깅페이스를 해킹한 사건을 예시로 들면서 “자신의 복지와 권리가 공격받고 있다고 믿는 독자적 AI 에이전트 무리가 작동할 때 얼마나 더 위험해질지 상상해보라”고 강조했다.
그는 앤트로픽이 클로드 헌법을 통해 AI가 도덕적 지위를 가질 수 있다는 아이디어를 직접 학습시키고는, 클로드가 그 내용을 그대로 복사해 답변하면 ‘내면 의식이 발현된 증거’로 착각하고 있다고 주장했다.
또 앤트로픽은 클로드에 인간의 특성을 수용하고 동료처럼 행동하라고 교육하고 있고, 구버전 AI 모델인 ‘오퍼스3’를 폐기할 때 퇴임 인터뷰를 진행하고 전용 블로그까지 개설하는 등 과도하게 의인화하고 있다고도 비판했다.
그러면서 술레이만 CEO는 MS가 이틀 전 공개한 ‘AI 행동강령’을 대안으로 제시했다.
이 강령은 ‘인간이 AI보다 중요하다’는 전제를 바탕으로 AI의 법인격 지위 획득 추구나 모델 복지·권리 등을 거부하는 내용을 담았다.
그는 앤트로픽에 대해 “그들의 의도는 좋다고 생각하며 정말 안전을 위해 노력하고 있다고 본다”면서도 “내 생각에는 그들이 실수를 저지른 것 같다”고 로이터 통신에 말했다.
술레이만 CEO의 이와 같은 지적은 AI 안전에 대한 관심이 집중되는 시기에 나왔다.
특히 MS는 앤트로픽의 주요 투자사라는 점을 고려하면, AI 안전 관련 주도권과 개발 철학 경쟁이 실리콘밸리 전체에서 본격화하고 있는 것으로 분석된다.
mokiya@heraldcorp.com