12일 토큰 최적화 기술 공개, 내년 사업 본격화
AX 기술 검증 완료…비용 90% 절감·효율 4배↑
인프라·모델·라우팅·하네스, 고객 가격 부담 절감
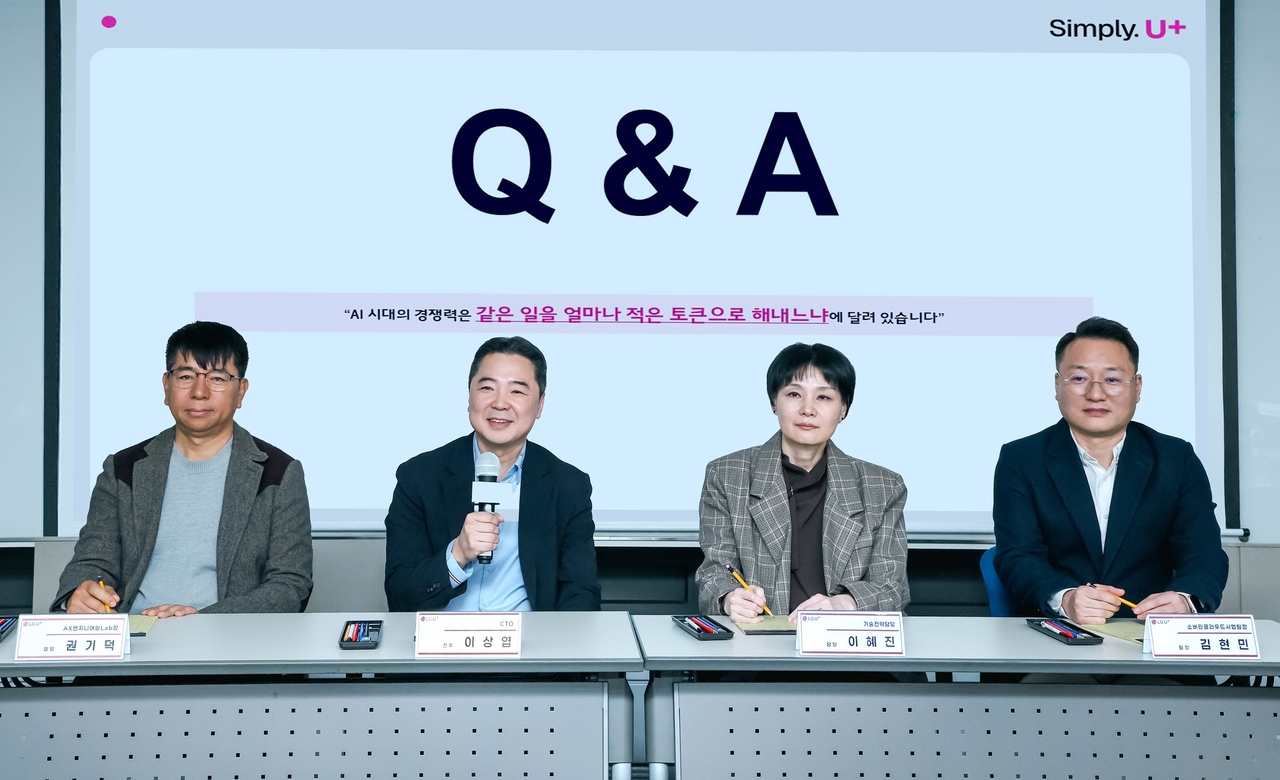
[헤럴드경제=고재우 기자] LG 유플러스가 내년부터 인공지능(AI) 토큰 최적화 전략을 기반으로 기업간거래(B2B) AI 시장에 ‘출사표’를 던진다. AI 에이전트 성능을 고도화하면서도, 토큰 비용을 획기적으로 절감해 B2B 시장을 주도하겠다는 복안이다.
AI 에이전트가 일상으로 다가오고 토큰 비용 절감이 화두가 되면서, 토큰 최적화 B2B 시장 선점을 위한 기업간 경쟁도 심화할 전망이다.
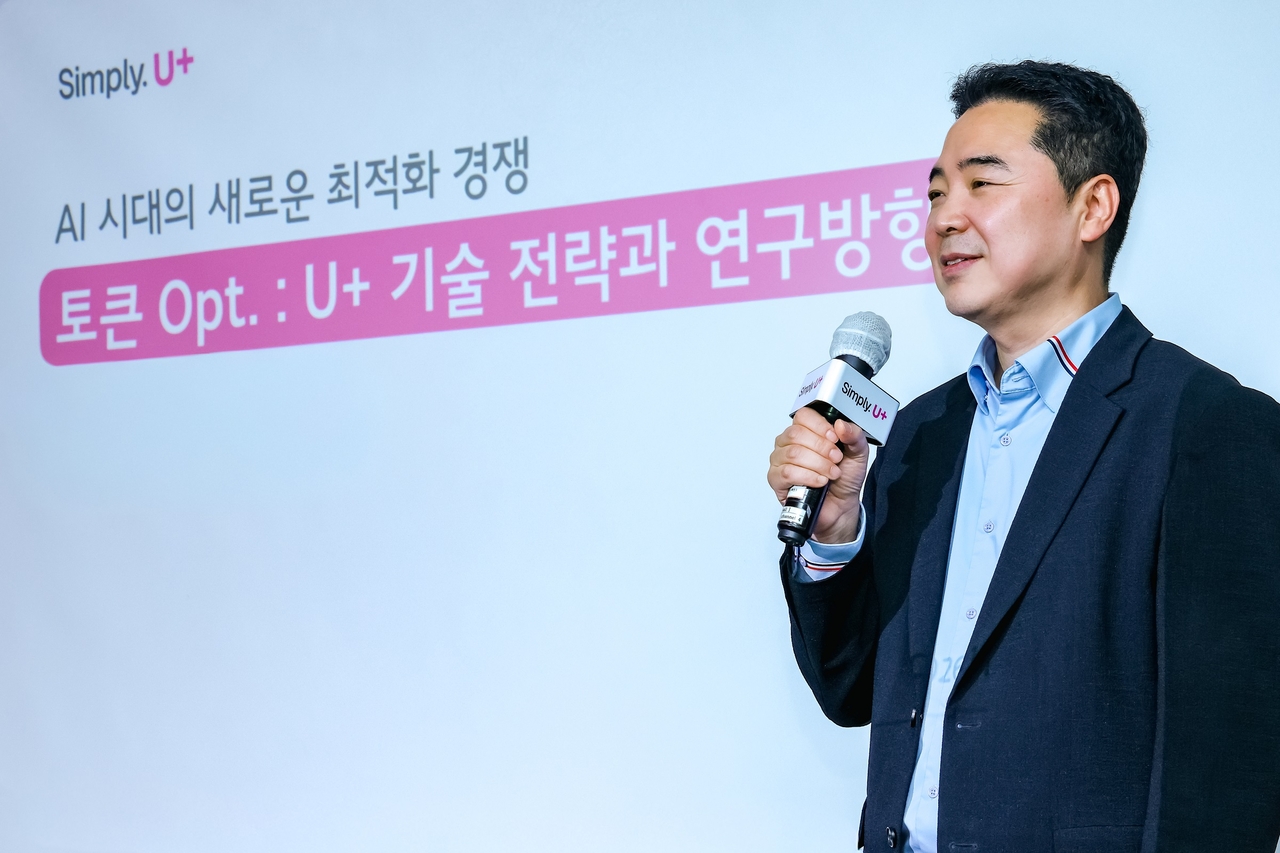
12일 서울 서대문구 모처에서 열린 LG유플러스 ‘AI 토큰 최적화 스터디’에서 이상엽 CTO는 토큰 최적화에 대해 “지속가능한 AI 사업의 핵심 해자(moat)가 될 것”이라며 이같이 밝혔다.
▶코딩 비용 ‘90%’↓·효율 ‘4배’↑, 모델 ‘경량화’·반도체 ‘최적화’ 등= 최근 AI 에이전트 확산으로 토큰 비용 절감이 화두가 됐다. AI 에이전트 일상화에 따른 비용 증가는 물론, AI 모델 단가가 저렴해도 불필요한 검색과 분석을 반복할수록 비용이 커지기 때문이다.
LG유플러스는 사내 기술실증(PoC)을 통해 토큰 최적화에 나섰다. 지속적인 실전 튜닝(조정)을 통해 자체 AI 모델과 엑사원 비중을 조합했다. 고성능 AI가 필요한 작업과, 가벼운 작업을 구분해 처리하면서 비용을 줄이는 식이다.
자체 검증 결과 토큰 소모가 심한 코딩 영역에서 통상 모델 대비 LG유플러스의 자체 AI 모델 운영 비용이 최대 90% 절감된 사례를 확인했다. 또 AI 모델의 연산 처리 방식을 개선해 동일 인프라 대비 처리 효율을 약 4배까지 높였다.
여기에 질문에 따라 적합한 AI 모델을 선택하는 ‘라우팅’과 함께 ‘반도체’를 통한 최적화 전략도 공개했다. 연산 능력이나 활용 빈도에 따라 상황에 맞는 반도체를 활용할 수 있다는 것이다.
권기덕 AX엔지니어링랩장은 “연산이 많이 필요한 영역인 프리필은 엔비디아 그래칙처리장치(GPU)에서 처리하고, 결과인 KV 캐시를 AMD GPU로 넘겨 메모리 활용이 중요한 디코딩을 수행한다”고 설명했다.
이어 “‘전문가 혼합 모델’을 활용해 자주 활용하는 전문가는 엔비디아 GPU를 배치하고, 활용 빈도가 낮은 전문가는 이전 세대 GPU 혹은 퓨리오사AI의 신경망처리장치(NPU)를 배치할 수 있다”고 덧붙였다.
이 CTO는 “모델 경량화, 최적화, 라우팅을 비롯해 모델 자체의 처리 효율을 높이는 기술”이라고 부연했다.
▶성능 유지, 비용 감소 ‘관건’…LG유플러스만이 가진 AX 전략은= 전 세계적으로 AI 활용이 일상화된 가운데, 기업으로서는 AI 모델 성능을 유지하면서도 비용 감소가 관건이 됐다. 최근 통신 3사뿐만 아니라 다양한 기업들이 토큰 최적화 시장에 뛰어들고 있는 이유다.
하지만 이게 쉽지 않다. 이혜진 기술전략담당은 “비용을 낮추는 데 집중하면 성능이 저하될 수 있고, 성능이 떨어져서 에이전트가 반복 혹은 추가 동작하면 비용이 는다”며 “업무 성공률을 높이고, 실패에 따른 비용을 줄이는 게 토큰 비용을 낮추는 것과 연결된다”고 말했다.
그러면서 “인력을 줄여준다는 기대에 AI를 도입했지만, 오히려 비용이 많이 드는 경우가 있다”며 “투입한 비용만큼 가치를 만들어내는 AI에이전트를 실무에 활용하는 데에 토큰 최적화가 중요한 역할을 한다”고 밝혔다.
이에 LG유플러스는 내년부터 풀스택 역량과 함께 빅테크와 협력 등을 바탕으로 토큰 최적화 사업에 본격적으로 뛰어든다.
김현민 소버린클라우드사업팀장은 “토큰 원가 경쟁력 확보, 고객 총소유비용(TCO) 관점에서 전체 토큰 사용 비용을 줄일 것”이라며 “협력사와 함께 제휴 사업 방식, 직접 구축하는 방식 등을 통해 사업을 추진할 것”이라고 예고했다.
이 CTO도 “회선부터, 인프라, 모델, 라우팅, 하네스(오케스트레이션) 전체 과정을 살피고, 고객의 의도까지 고려해 최적화할 필요가 있다”며 “사내 AX에서도 빅테크 에이전트 설루션과 자체 모델을 함께 활용하는 등 빅테크와도 협력할 것”이라고 강조했다.
ko@heraldcorp.com